Pseudonimizzazione dei dati: cos’è, esempi e differenza con l’anonimizzazione (GDPR, 2026)
La pseudonimizzazione dei dati è il trattamento che sostituisce gli identificativi con codici, così che i dati non siano più attribuibili all’interessato senza informazioni aggiuntive, conservate separatamente e protette (art. 4, n. 5, GDPR). A differenza dei dati anonimi, i dati pseudonimizzati restano ricollegabili alla persona con quelle informazioni: in linea di principio sono dati personali. Per la Corte di giustizia (2025) possono, a seconda delle circostanze, non esserlo per chi non può re-identificarli. Informazione generale, non consulenza legale.
Pseudonimizzazione GDPR: la definizione dell’art. 4, n. 5
5) «pseudonimizzazione»: il trattamento dei dati personali in modo tale che i dati personali non possano più essere attribuiti a un interessato specifico senza l’utilizzo di informazioni aggiuntive, a condizione che tali informazioni aggiuntive siano conservate separatamente e soggette a misure tecniche e organizzative intese a garantire che tali dati personali non siano attribuiti a una persona fisica identificata o identificabile;
(Fonti: Regolamento UE 2016/679, testo italiano, PDF del Garante; stessa formula sulla pagina tema «Pseudonimizzazione» del Garante; consultati il 22 settembre 2026.)
In termini tecnici, secondo una presentazione formativa del Garante del 29 settembre 2025, la pseudonimizzazione «consiste nel sostituire un attributo, solitamente univoco, di un dato con un altro, ugualmente univoco e solitamente non immediatamente intellegibile». (Fonte: Garante, «Pseudonimizzazione Anonimizzazione», slide in PDF, consultato il 22 settembre 2026.)
Il considerando 28 ne spiega il senso: la pseudonimizzazione «può ridurre i rischi per gli interessati» e aiutare titolari e responsabili del trattamento a rispettare i loro obblighi, senza «precludere altre misure di protezione dei dati». Il considerando 29 la incentiva, ammettendo analisi generali «nell’ambito dello stesso titolare del trattamento» se questi ha adottato le misure necessarie e le informazioni aggiuntive restano conservate separatamente. (Fonte: GDPR, considerando 28 e 29, consultato il 22 settembre 2026.)
Esempi di pseudonimizzazione: tecniche e documenti
ENISA, nel rapporto del novembre 2019 sulle tecniche di pseudonimizzazione e le migliori pratiche, descrive contatore, generatore di numeri casuali, hash crittografico, codice di autenticazione del messaggio (MAC) e cifratura; per le Linee guida 01/2025 del Comitato europeo per la protezione dei dati (EDPB) le procedure più usate sono due, algoritmi crittografici e tabelle di corrispondenza. Con un hash a chiave segreta (HMAC), ricalcolare il codice senza la chiave è molto più difficile: per ENISA il MAC è in genere una tecnica robusta, finché la chiave non è compromessa. (Fonti: ENISA, Pseudonymisation techniques and best practices, § 5.1; EDPB, Guidelines 01/2025, par. 87; WP29, parere 05/2014, § 4 (hash con chiave); consultati il 22 settembre 2026.)
Quattro documenti e una riga di database, con dati inventati (etichette dei segnaposto illustrative):
| Documento | Originale | Copia pseudonimizzata | Da ricontrollare |
|---|---|---|---|
| Atto giudiziario | R.G. 4521/2025, Marco Bellini, nato a Brescia il 12/03/1971, contro Ferri Costruzioni S.r.l. | R.G. <ID_1>, <PERSON_1>, nato a <LOCATION_1> il <DATE_1>, contro <ORG_1> | Testimoni e numero di ruolo, citati dall’Ordine di Milano |
| Referto | Giulia Neri, nata il 14/08/1985, via Po 12, Torino. Diagnosi: diabete di tipo 2 | <PERSON_1>, nata il <DATE_1>, <LOCATION_1>. Diagnosi: diabete di tipo 2 | La diagnosi resta: la copia è ancora un dato personale |
| Fattura | Fattura n. 118 a Studio Rinaldi, IBAN IT00 X000 0000 0000 0000 0000 000, 3.450,00 € | Fattura n. 118 a <ORG_1>, IBAN <IBAN_1>, 3.450,00 € | Numero e importo: con la contabilità riportano al cliente |
| Curriculum | Luca Ferrari, [email protected], dal 2019 responsabile acquisti di Alfa Logistica S.p.A. | <PERSON_1>, <EMAIL_1>, dal 2019 responsabile acquisti di <ORG_1> | Ruolo e anno: in un settore ristretto possono bastare a riconoscerlo |
| Database clienti (una riga) | Anna Galli; 05/11/1990; Bergamo; acquisti 2025: 1.200 € | 000123 (contatore) oppure un codice HMAC; 05/11/1990; Bergamo; acquisti 2025: 1.200 € | Data di nascita e comune, insieme, possono bastare a riconoscerla |
Per gli atti giudiziari l’Ordine degli Avvocati di Milano indica «i dati personali delle parti e di soggetti terzi (es. testimoni) e, anche, il numero di ruolo della causa»; consultato il 22 settembre 2026.
Togliere il nome e lasciare codice fiscale o indirizzo, a stare alla lettera della norma, non basta: l’art. 4, n. 1 cita tra gli identificativi «un numero di identificazione» e i «dati relativi all’ubicazione», e il documento resta attribuibile senza informazioni aggiuntive. Debole anche l’hash di valori prevedibili calcolato senza chiave: per il Gruppo di lavoro articolo 29 (WP29), se un dataset è stato pseudonimizzato con l’hash del numero di identificazione nazionale, quel numero si ricava calcolando l’hash di tutti i valori possibili e confrontando i risultati. L’EDPB fa un esempio analogo con lo SHA-256 di un nome; ENISA considera l’hash in genere debole, perché esposto ad attacchi a forza bruta e a dizionario. (Fonti: GDPR, art. 4, n. 1; WP29, parere 05/2014, § 4; EDPB, Guidelines 01/2025, nota 23; ENISA, 2019; consultati il 22 settembre 2026.)
Pseudonimizzazione e anonimizzazione: la differenza
Tra anonimizzazione e pseudonimizzazione il confine è l’identificabilità, e da essa dipende se il GDPR si applica. Per il considerando 26 i dati pseudonimizzati, «i quali potrebbero essere attribuiti a una persona fisica mediante l’utilizzo di ulteriori informazioni», «dovrebbero essere considerati informazioni su una persona fisica identificabile», mentre alle informazioni anonime il regolamento «non si applica». Conta la possibilità di ricollegare i dati alla persona, non quella di invertire un calcolo: un codice HMAC non si inverte, ma chi ha la chiave può ricalcolarlo dal dato originale, e resta una tecnica di pseudonimizzazione. L’Ordine degli Avvocati di Milano, nelle istruzioni per i documenti allegati alla domanda di specializzazione per comprovata esperienza, contrappone l’anonimizzazione, che trasforma «irreversibilmente i dati personali in dati anonimi», alla pseudonimizzazione, de-identificazione «reversibile che può ridurre il “rischio privacy” senza, tuttavia, poterlo azzerare». (Fonti: GDPR, considerando 26; ENISA, 2019, § 5.1.4 (MAC); WP29, parere 05/2014, § 4 (hash con chiave); Ordine degli Avvocati di Milano; consultati il 22 settembre 2026.)
| Pseudonimizzato | Anonimo | Cifrato | |
|---|---|---|---|
| Ricollegabile alla persona? | Sì, con le informazioni aggiuntive conservate a parte | No: i dati anonimizzati non consentono l’identificazione con i mezzi di cui dispone chi tenta di identificarli, titolare o altro soggetto | Sì, per chi ha la chiave di decifratura |
| È un dato personale? | In linea di principio sì; per un destinatario senza mezzi di re-identificazione, a seconda delle circostanze, può non esserlo (Corte di giustizia, 2025) | No | In linea di principio sì, come i dati pseudonimizzati: la cifratura è uno strumento di pseudonimizzazione |
| Si applica il GDPR? | Sì, per il titolare e per chi può re-identificare | No (considerando 26) | Sì, per chi ha o può ottenere la chiave |
| Esempio | Atto con <PERSON_1>, tabella di corrispondenza sul computer dello studio | Conteggio aggregato senza persone isolabili, collegabili o deducibili | Archivio cifrato, chiave custodita dallo studio |
(Fonti: GDPR, considerando 26; Corte di giustizia, comunicato n. 107/25; Garante, slide del 29 settembre 2025. Per la cifratura: documento congiunto dell’autorità spagnola (AEPD) e dell’EDPS sui dieci malintesi relativi all’anonimizzazione (2021, PDF in inglese sul sito dell’EDPS); nella sintesi in italiano di Altalex (M. Martorana e L. Pinelli, 8 giugno 2021, copia d’archivio del 3 novembre 2023) la crittografia «risulta in realtà essere uno strumento di pseudonimizzazione». Esempi della riga finale: nostri. Consultati il 22 settembre 2026.)
Quando un dato è anonimo? Il parere WP29 05/2014, del 10 aprile 2014, indicava tre rischi: singling out (isolare i record che identificano una persona), linkability (collegare due record della stessa persona) e inference (dedurre un attributo dai valori di altri). Le Linee guida EDPB 02/2026 sull’anonimizzazione, adottate il 7 luglio 2026 e in consultazione fino al 30 ottobre 2026, li riformulano come tre criteri: nessun isolamento dei record (al posto del singling out), nessun collegamento, nessuna inferenza. Se sono soddisfatti tutti e tre, i dati possono considerarsi anonimi; ma, precisa il comunicato dell’EDPB, la risposta può variare da un soggetto all’altro. (Fonti: WP29, parere 05/2014 (WP216); EDPB, comunicato dell’8 luglio 2026 e pagina della consultazione 02/2026; consultati il 22 settembre 2026.)
I dati pseudonimizzati sono ancora dati personali?
Per chi li ha pseudonimizzati, sì. Nel comunicato italiano del 17 gennaio 2025 l’EDPB scrive che i dati pseudonimizzati «sono pertanto ancora dati personali», e precisa: «se i dati possono essere ricollegati a una persona fisica dal titolare del trattamento o da qualcun altro, rimangono dati personali». La copia con i segnaposto e la tabella di corrispondenza restano quindi, per chi le detiene, soggette al GDPR. (Fonte: EDPB, comunicato del 17 gennaio 2025, consultato il 22 settembre 2026.)
La sentenza SRB («Deloitte») della Corte di giustizia (C-413/23 P, 4 settembre 2025)
Nella procedura seguita alla risoluzione del Banco Popular Español, il Comitato di risoluzione unico (Single Resolution Board, SRB) aveva trasmesso alcune osservazioni, in forma di dati pseudonimizzati, a Deloitte, incaricata di una valutazione degli effetti della risoluzione. Alcuni azionisti e creditori avevano presentato reclamo al Garante europeo della protezione dei dati (GEPD, in inglese EDPS) perché l’SRB non li aveva informati della trasmissione a Deloitte. Su impugnazione dell’EDPS, il 4 settembre 2025 la Corte di giustizia (causa C-413/23 P) ha annullato la sentenza del Tribunale dell’UE e gli ha rinviato la causa.
| Comunicato CURIA n. 107/25 (in inglese) | La nostra sintesi |
|---|---|
| «pseudonymised data must not be regarded as constituting, in all cases and for every person, personal data» | Non sempre, e non per chiunque, i dati pseudonimizzati sono dati personali. |
| «pseudonymisation may, depending on the circumstances of the case, effectively prevent persons other than the controller from identifying the data subject in such a way that, for them, the data subject is not or is no longer identifiable» | A seconda delle circostanze, la pseudonimizzazione può impedire a chi non è il titolare di identificare l’interessato: per lui, allora, i dati non sono (più) personali. |
| «With regard to that obligation to provide information, […] the identifiable nature of the data subject must be assessed at the time of collection of the data and from the point of view of the controller» | Per l’obbligo di informare gli interessati, l’identificabilità si valuta al momento della raccolta dei dati, dal punto di vista del titolare. |
(Fonte: Corte di giustizia, comunicato stampa n. 107/25, 4 settembre 2025, in inglese; consultato il 22 settembre 2026.)
La norma applicata non era il GDPR ma il regolamento (UE) 2018/1725, che disciplina i trattamenti di dati personali da parte delle istituzioni, degli organi e degli organismi dell’Unione. L’EDPB tiene conto espressamente della sentenza nelle Linee guida 02/2026. Secondo la nota di Amarillide Genovese su giustiziacivile.com (13 novembre 2025), i dati pseudonimizzati restano «in linea di principio» informazioni su una persona identificabile, ma l’identificabilità va «apprezzata in concreto, in considerazione della ragionevole probabilità di accesso alla re-identificazione della persona». (Fonti: comunicato CURIA n. 107/25, nota 1; EDPB, comunicato dell’8 luglio 2026; giustiziacivile.com, estratto libero del commento; consultati il 22 settembre 2026.)
La sentenza non rende anonimi i dati per chi conserva la chiave: anche la sintesi di privacy.it precisa che la relatività del concetto «non esime il controller dalle sue obbligazioni». (Fonte: privacy.it, 4 settembre 2025, sintesi non ufficiale; consultato il 22 settembre 2026.)
Linee guida EDPB 01/2025 sulla pseudonimizzazione: cosa dicono e a che punto sono
L’EDPB le ha adottate all’unanimità nella 101ª plenaria, il 16 gennaio 2025, e annunciate con il comunicato del 17 gennaio. La consultazione pubblica, annunciata fino al 28 febbraio 2025, si è chiusa il 14 marzo 2025. Al 22 settembre 2026 non risulta adottata una versione definitiva: il PDF si presenta ancora come versione adottata per la consultazione pubblica, e tra le notizie dell’EDPB sul tema non compare alcuna adozione finale. (Fonti: verbale della 101ª plenaria; comunicato del 17 gennaio 2025; pagina della consultazione; PDF delle linee guida; pagina tema EDPB; consultati il 22 settembre 2026.)
Secondo il comunicato italiano, la pseudonimizzazione può facilitare il ricorso all’interesse legittimo (art. 6, par. 1, lett. f), GDPR), «purché siano soddisfatti tutti gli altri requisiti del GDPR», e contribuire alla compatibilità con la finalità originaria (art. 6, par. 4) e al rispetto di principi, protezione fin dalla progettazione e sicurezza (artt. 5, 25 e 32).
Le linee guida, disponibili solo in inglese (non ne abbiamo trovato una versione italiana), chiamano «dominio di pseudonimizzazione» (traduzione nostra) il contesto, definito dal titolare, in cui la pseudonimizzazione deve impedire l’attribuzione dei dati a persone specifiche. Per un documento inviato a un’IA, a nostro avviso, il dominio comprende il fornitore, le persone che vi hanno accesso e le risorse di cui dispone, e va definito caso per caso.
Nel verbale di quella plenaria, un membro aveva osservato che della causa C-413/23 P, allora pendente, si doveva tenere conto nell’adottare le linee guida: si è convenuto che la causa non imponeva di rinviare la pubblicazione, ma che l’EDPB avrebbe valutato se richiedesse una revisione. La sentenza è arrivata nel settembre 2025; la versione definitiva delle linee guida, a oggi, no.
Dove il GDPR cita la pseudonimizzazione
Oltre alla definizione, il regolamento la nomina in questi articoli:
| Articolo | Contesto | Testo |
|---|---|---|
| Art. 6, par. 4, lett. e) | Compatibilità con la finalità originaria | «dell’esistenza di garanzie adeguate, che possono comprendere la cifratura o la pseudonimizzazione» |
| Art. 25, par. 1 | Protezione dei dati fin dalla progettazione (privacy by design) | «misure tecniche e organizzative adeguate, quali la pseudonimizzazione, volte ad attuare in modo efficace i principi di protezione dei dati, quali la minimizzazione» |
| Art. 32, par. 1, lett. a) | Sicurezza del trattamento | «la pseudonimizzazione e la cifratura dei dati personali» |
| Art. 40, par. 2, lett. d) | Codici di condotta | «la pseudonimizzazione dei dati personali» |
| Art. 89, par. 1 | Archiviazione nel pubblico interesse, ricerca, statistica | «Tali misure possono includere la pseudonimizzazione, purché le finalità in questione possano essere conseguite in tal modo» |
(Fonte: Regolamento UE 2016/679, testo italiano, PDF del Garante; il contesto degli artt. 6, par. 4, 25 e 32 riprende il comunicato EDPB del 17 gennaio 2025; consultati il 22 settembre 2026.)
L’art. 25 GDPR, la norma della privacy by design, sceglie proprio la pseudonimizzazione come esempio di misura; nell’art. 32 GDPR è la prima delle misure di sicurezza elencate. Letti insieme, però, questi testi non ne fanno un obbligo generale: «quali» all’art. 25, «possono» all’art. 89 e il considerando 28 lasciano spazio ad altre misure.
Quando la pseudonimizzazione non basta: i casi di re-identificazione
Il WP29 lo scriveva nel 2014: sostituire un attributo lascia la persona «still likely to be identified indirectly», e la pseudonimizzazione è «a useful security measure but not a method of anonymisation» (citazioni in inglese). (Fonte: WP29, parere 05/2014, consultato il 22 settembre 2026.)
AOL, 2006. Il New York Times del 9 agosto 2006 racconta che «it did not take much investigating» per risalire dall’utente indicato come «AOL Searcher No. 4417749» a una vedova di 62 anni di Lilburn, in Georgia. «Those are my searches», ha detto lei quando un giornalista le ha letto parte dell’elenco (citazioni in inglese). (Fonte: M. Barbaro e T. Zeller Jr., «A Face Is Exposed for AOL Searcher No. 4417749», copia dell’articolo archiviata dall’EFF; consultato il 22 settembre 2026.)
Tre attributi, poi quindici. Latanya Sweeney (Carnegie Mellon, 2000) ha stimato che l’87 % della popolazione degli Stati Uniti, 216 milioni di persone su 248, era probabilmente identificabile in modo univoco in base ai soli codice postale a cinque cifre, sesso e data di nascita dichiarati. Rocher, Hendrickx e de Montjoye (Nature Communications, 2019) stimano, con il loro modello, che il 99,98 % degli americani sarebbe re-identificato correttamente in qualunque dataset con 15 attributi demografici. (Fonti: L. Sweeney, «Simple Demographics Often Identify People Uniquely»; Rocher, Hendrickx e de Montjoye, Nature Communications; consultati il 22 settembre 2026.)
Per un documento vale lo stesso: date di nascita, luoghi, ruoli e aziende possono bastare, insieme, a riconoscere una persona.
Pseudonimizzare un documento prima di usare l’IA
Un atto da riassumere, un referto da spiegare, un contratto da confrontare: se il testo arriva a un assistente di
IA con i nomi in chiaro, il fornitore riceve i dati personali del cliente o del paziente. Se nomi, indirizzi e numeri
diventano segnaposto coerenti (la stessa persona è sempre <PERSON_1>) e la tabella
di corrispondenza resta sul computer di chi lavora, lo schema è quello dell’art. 4, n. 5: il fornitore riceve
codici, l’informazione aggiuntiva resta separata.
Dove tenere la tabella? L’art. 4, n. 5 chiede che sia conservata separatamente e protetta, non che la tenga di persona il titolare. Per questo flusso, a nostro avviso, la scelta più sicura è tenerla in locale, presso lo studio o l’azienda. Allegarla al testo inviato è un’altra cosa: dà al destinatario proprio i mezzi per re-identificare su cui ragiona la sentenza SRB.
Fatto a mano su un fascicolo lungo, è un lavoro fragile: un nome sfugge in una nota, la stessa persona cambia sigla da un paragrafo all’altro. Nelle istruzioni già citate, l’Ordine di Milano chiede all’avvocato, «in qualità di titolare del trattamento», la «pseudo-anonimizzazione dei dati personali», consiglia software «provvisti di OCR» e sconsiglia annerimento e sbianchettatura manuali, perché «tale operazione non garantisce livelli di sicurezza particolarmente tutelanti». Prima di inviare un documento a un’IA, a nostro avviso, il rischio è lo stesso: basta un nome sfuggito. (Fonte: Ordine degli Avvocati di Milano, consultato il 22 settembre 2026.)
Il flusso passo per passo: anonimizzare i documenti prima di ChatGPT; per gli studi legali, ChatGPT per avvocati; per i commercialisti, la guida CNDCEC sull’IA.
Pseudonimizzare in locale con Occlira
Occlira, app desktop per Windows e macOS (Apple Silicon), lavora sui file in locale con due strumenti che per il GDPR non sono la stessa cosa.
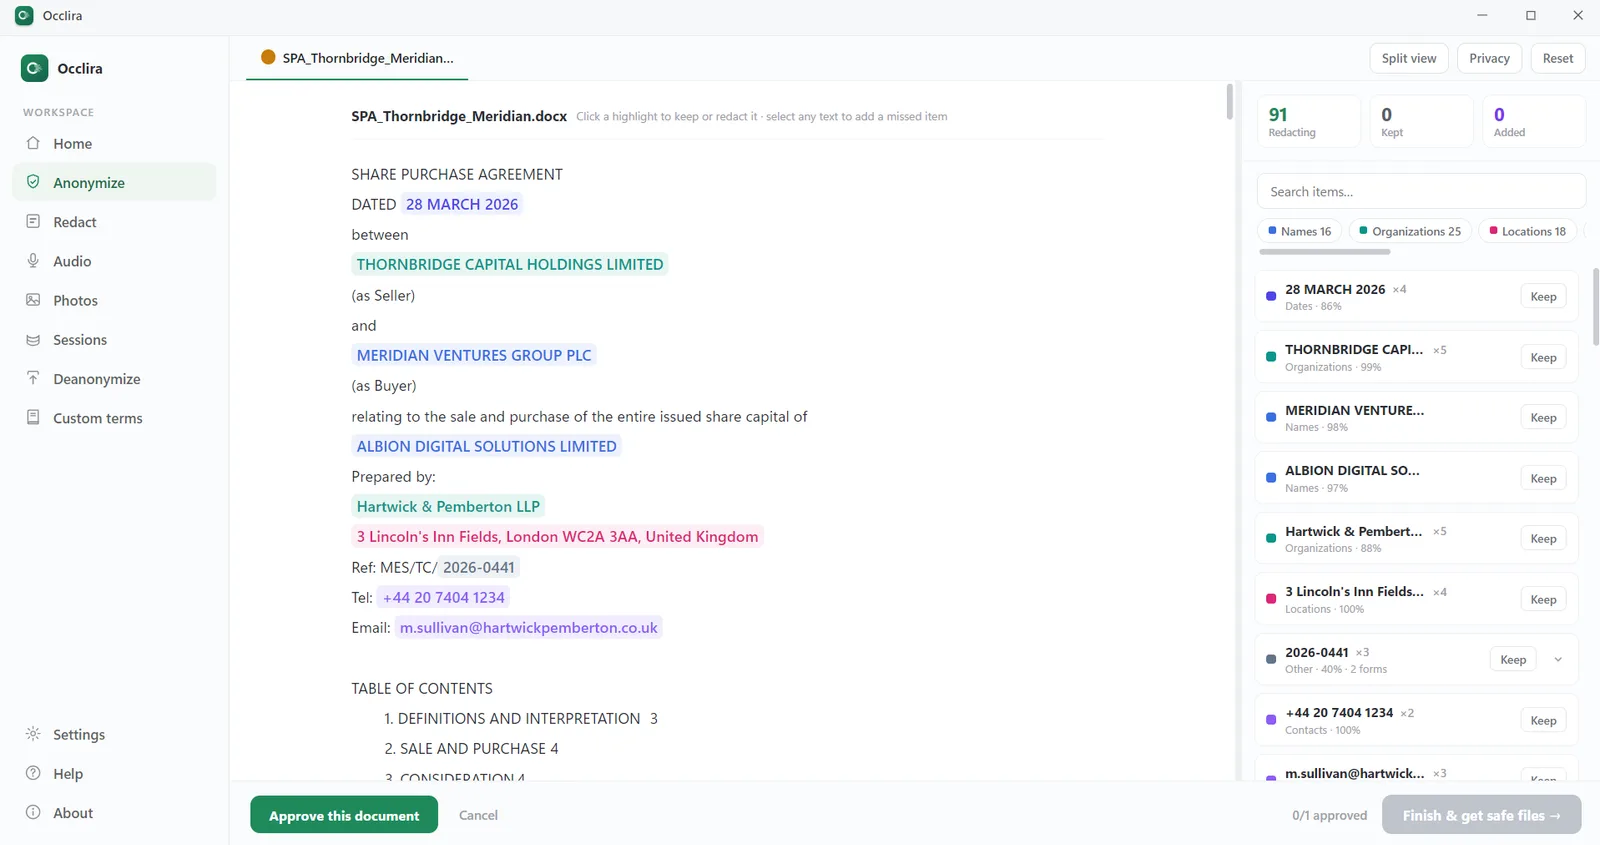
Anonymize è una pseudonimizzazione nel senso dell’art. 4, n. 5. Il rilevamento, un modello locale
più regole basate su pattern, propone gli identificativi con un punteggio di confidenza; lei li rivede, aggiunge ciò
che manca selezionandolo nel testo, e ogni valore diventa un segnaposto coerente come <PERSON_1>.
Word ed Excel restano nel loro formato, con la formattazione; commenti, revisioni e proprietà del documento vengono
ripuliti. PDF, email EML e immagini, scansioni comprese (OCR sul dispositivo), diventano un .txt; il testo si copia
con «Copy anonymized text». La tabella resta sul suo computer (permessi 0600) e scade dopo 7 giorni, durata
configurabile. La risposta dell’IA, salvata in un file, passa da Deanonymize: ne esce una copia
_restored con i valori reali.
Redact, per PDF e immagini di testo, invece elimina i dati, senza sostituirli. Dopo un’anteprima in cui ogni termine trovato ha il suo
riquadro (si può escludere, aggiungere un termine sfuggito, disegnare un riquadro a mano), l’oscuramento viene
impresso in un nuovo file nome_redacted.pdf fatto solo di immagini, senza livello di testo né
metadati o annotazioni dell’originale, che resta intatto. È irreversibile e non c’è tabella di corrispondenza; un
controllo finale verifica che nessun termine sia ancora estraibile (sulle scansioni è solo indicativo), e il testo
del PDF oscurato non si seleziona più. Redact toglie i dati da quella copia, ma non ne fa un documento «anonimo» ai
sensi del considerando 26: il contesto che resta va valutato.
Il rilevamento funziona offline; l’app usa la rete solo per attivare la licenza tramite Polar, scaricare il modello e controllare gli aggiornamenti. Con l’app desktop avviata funzionano anche i connettori locali: estensione Chrome per ChatGPT, Claude e Gemini (sullo stesso PC Windows), connettore MCP per Claude Desktop, componente aggiuntivo per Word desktop. Occlira aiuta a pseudonimizzare con metodo; non garantisce la conformità al GDPR e non sostituisce la valutazione del titolare.
Domande frequenti
Per pseudonimizzazione si intende il trattamento che rende i dati non più attribuibili a una persona specifica senza informazioni aggiuntive, come una tabella di corrispondenza o una chiave. È la definizione dell’art. 4, n. 5, del GDPR, che pone due condizioni: quelle informazioni vanno conservate separatamente e protette con misure tecniche e organizzative.
I dati pseudonimizzati restano attribuibili alla persona con informazioni aggiuntive conservate a parte: sono dati personali e il GDPR si applica. L’anonimizzazione punta a impedire l’identificazione con i mezzi di cui dispone chi tenta di identificare la persona, titolare o altri; se ci riesce, il regolamento non si applica. Per verificarlo, le linee guida EDPB del 2026 usano tre criteri: nessun isolamento dei record, nessun collegamento, nessuna inferenza.
In linea di principio sì: il considerando 26 e l’EDPB li considerano informazioni su una persona identificabile, perché qualcuno può ricollegarli alla persona. Nel 2025 la Corte di giustizia ha precisato che, per un destinatario senza mezzi di re-identificazione, a seconda delle circostanze possono non esserlo. Per il titolare che conserva la chiave restano comunque dati personali.
Non come regola generale. Il GDPR la indica come esempio di misura adeguata per la protezione dei dati fin dalla progettazione (art. 25) e la elenca, accanto alla cifratura, tra le misure di sicurezza (art. 32). Spetta al titolare mettere in atto misure adeguate: la pseudonimizzazione è una di quelle possibili, non l’unica.
Può esserlo. ENISA elenca la cifratura tra le tecniche di pseudonimizzazione, e le Linee guida EDPB 01/2025 indicano tra gli strumenti adatti gli HMAC e gli schemi di cifratura che garantiscono l’indistinguibilità del testo cifrato. Non è invece un’anonimizzazione: chi ha la chiave di decifratura riottiene i dati in chiaro. Il GDPR nomina le due misure una accanto all’altra (art. 32).
È una tecnica di pseudonimizzazione, e debole se non usa una chiave: su valori prevedibili, come nomi o numeri di identificazione, basta calcolare l’hash di tutti i candidati e confrontare i risultati. Più robusto è un hash con chiave segreta (HMAC), finché la chiave resta protetta. Da sola, la pseudonimizzazione non produce un dataset anonimo.
Il 4 settembre 2025 (C-413/23 P), su impugnazione dell’EDPS, la Corte ha annullato la sentenza del Tribunale dell’UE e gli ha rinviato la causa. Sul punto dei dati pseudonimizzati ha però dato ragione al Tribunale: non sono dati personali sempre e per chiunque. Per l’obbligo di informare, invece, conta il momento della raccolta e il punto di vista del titolare.
Non è l’unica misura possibile, ma riduce ciò che il fornitore riceve: il testo arriva con codici al posto di nomi e numeri, e la tabella di corrispondenza resta presso lo studio o l’azienda. Non rende anonimo il trattamento e non lo sottrae al GDPR; date, luoghi e ruoli rimasti nel testo vanno comunque ricontrollati prima dell’invio.
L’art. 4, n. 5 non dice chi la debba tenere: chiede che sia conservata separatamente dai dati pseudonimizzati e protetta da misure tecniche e organizzative; di norma la tiene il titolare. Se la chiave arriva anche a chi riceve i dati, per esempio allegata al testo, quel destinatario può re-identificare le persone.
La pseudonimizzazione non autorizza di per sé la condivisione: restano da verificare base giuridica, finalità, minimizzazione, accordi con il destinatario, sicurezza ed eventuali trasferimenti fuori dall’UE. In pratica si invia solo la copia con i segnaposto; la tabella di corrispondenza non viaggia mai con i dati, né nella stessa email né nella stessa cartella.
Per approfondire: che cosa sono i dati personali · oscurare Word, PDF ed Excel
Lo provi su un suo documento
Gratis per 14 giorni su Windows e macOS (Apple Silicon). Licenza una tantum da 149 € a postazione, senza abbonamento.