Pseudonymisation des données : définition, exemples et différence avec l’anonymisation (RGPD, 2026)
La pseudonymisation consiste à remplacer les identifiants d’une personne par des pseudonymes, afin que les données ne puissent plus lui être attribuées sans informations supplémentaires, conservées séparément et protégées (RGPD, art. 4). Contrairement à l’anonymisation, elle peut laisser la personne identifiable pour quiconque détient ces informations : les données pseudonymisées restent en principe des données personnelles. D’après la CJUE (2025), elles peuvent, selon les circonstances, ne pas l’être pour un destinataire sans moyens de réidentification. Information générale, pas un conseil juridique.
Pseudonymisation : définition (article 4 du RGPD)
« pseudonymisation », le traitement de données à caractère personnel de telle façon que celles-ci ne puissent plus être attribuées à une personne concernée précise sans avoir recours à des informations supplémentaires, pour autant que ces informations supplémentaires soient conservées séparément et soumises à des mesures techniques et organisationnelles afin de garantir que les données à caractère personnel ne sont pas attribuées à une personne physique identifiée ou identifiable ;
(Source : RGPD, article 4, texte hébergé par la CNIL, consulté le 22 septembre 2026.)
En pratique, écrit la CNIL, la pseudonymisation « consiste à remplacer les données directement identifiantes (nom, prénom, etc.) d’un jeu de données par des données indirectement identifiantes (alias, numéro séquentiel, etc.) ». (Source : CNIL, « L’anonymisation de données personnelles », page du 19 mai 2020, consultée le 22 septembre 2026.)
Exemples de pseudonymisation : techniques et documents
Pour fabriquer les pseudonymes, la CNIL distingue des techniques « relativement basiques (compteur, générateur de nombre aléatoire) » et d’autres qui « s’appuient sur les techniques cryptographiques (chiffrement à clé secrète, fonction de hachage) ». Un hachage sans clé appliqué à des valeurs prévisibles reste vulnérable aux essais exhaustifs : pour le groupe de travail « article 29 » (G29), si un ensemble de données a été pseudonymisé en procédant au hachage du numéro d’identification national, « il peut être reconstitué simplement en appliquant la fonction de hachage à toutes les valeurs possibles et en comparant les résultats avec les valeurs figurant dans l’ensemble de données ». Avec une fonction de hachage à clé secrète, le même calcul devient « beaucoup plus difficile pour un attaquant » qui ignore la clé. (Source : CNIL, « Recherche scientifique (hors santé) : enjeux et avantages de l’anonymisation et de la pseudonymisation », 13 janvier 2022 ; G29, avis 05/2014 sur les techniques d’anonymisation, section 4 ; consultés le 22 septembre 2026.)
Dans un document, le plus simple est un marqueur cohérent par identifiant : la même personne devient partout <PERSON_1>, la correspondance étant conservée ailleurs. Trois documents et une ligne de fichier, avec des données inventées (libellés des marqueurs donnés à titre d’illustration) :
| Document | Original | Copie pseudonymisée | Encore à relire |
|---|---|---|---|
| Jugement | RG n° 25/04521, M. Julien Moreau, né le 12/03/1971 à Lyon, contre la SARL Ferrand Bâtiment | RG n° <ID_1>, M. <PERSON_1>, né le <DATE_1> à <LOCATION_1>, contre la <ORG_1> | Témoins, fonctions (« le gérant »), date d’audience |
| Compte rendu médical | Claire Dubois, née le 14/08/1985, 12 rue des Lilas, Nantes. Diagnostic : diabète de type 2 | <PERSON_1>, née le <DATE_1>, <LOCATION_1>. Diagnostic : diabète de type 2 | Le diagnostic reste : la copie demeure une donnée personnelle |
| Facture | Facture n° 118 au cabinet Roussel, IBAN FR76 0000 0000 0000 0000 0000 000, 3 450,00 € | Facture n° 118 à <ORG_1>, IBAN <IBAN_1>, 3 450,00 € | Numéro et montant, rapprochés de la comptabilité, renvoient au client |
| Fichier clients (une ligne) | Anne Garnier ; 05/11/1990 ; Rennes ; achats 2025 : 1 200 € | 000123 (compteur) ; 05/11/1990 ; Rennes ; achats 2025 : 1 200 € | Date de naissance et commune, ensemble, peuvent suffire à la reconnaître |
Retirer le nom en laissant le numéro de sécurité sociale ne suffit pas : l’article 4, point 1, cite « un numéro d’identification » parmi les identifiants. Même bien faite, la substitution laisse du contexte : il est « bien souvent possible de retrouver l’identité » des personnes « grâce à des données tierces », relève la CNIL. (Sources : RGPD, article 4, point 1 ; CNIL, 2020 ; consultés le 22 septembre 2026.)
Les études le chiffrent. Latanya Sweeney estimait en 2000 que 87 % de la population des États-Unis était probablement unique au vu de la seule combinaison du code postal à cinq chiffres, du sexe et de la date de naissance. Selon le modèle de Rocher, Hendrickx et de Montjoye (Nature Communications, 2019), 99,98 % des Américains seraient correctement réidentifiés dans n’importe quel jeu de données comportant 15 attributs démographiques. (Sources : L. Sweeney, « Simple Demographics Often Identify People Uniquely » ; Rocher, Hendrickx et de Montjoye, Nature Communications ; en anglais, consultés le 22 septembre 2026.)
Pseudonymisation et anonymisation des données : la différence
Entre pseudonymisation et anonymisation, la ligne de partage est l’identifiabilité, et c’est d’elle que dépend l’application du RGPD. Le considérant 26 la trace ainsi :
« Les données à caractère personnel qui ont fait l’objet d’une pseudonymisation et qui pourraient être attribuées à une personne physique par le recours à des informations supplémentaires devraient être considérées comme des informations concernant une personne physique identifiable. Pour déterminer si une personne physique est identifiable, il convient de prendre en considération l’ensemble des moyens raisonnablement susceptibles d’être utilisés par le responsable du traitement ou par toute autre personne pour identifier la personne physique directement ou indirectement, tels que le ciblage. Pour établir si des moyens sont raisonnablement susceptibles d’être utilisés pour identifier une personne physique, il convient de prendre en considération l’ensemble des facteurs objectifs, tels que le coût de l’identification et le temps nécessaire à celle-ci, en tenant compte des technologies disponibles au moment du traitement et de l’évolution de celles-ci. Il n’y a dès lors pas lieu d’appliquer les principes relatifs à la protection des données aux informations anonymes, à savoir les informations ne concernant pas une personne physique identifiée ou identifiable, ni aux données à caractère personnel rendues anonymes de telle manière que la personne concernée ne soit pas ou plus identifiable. »
(Source : RGPD, considérant 26, texte français sur privacy-regulation.eu, miroir non officiel, consulté le 22 septembre 2026.)
Ce qui compte est donc la possibilité, avec des moyens raisonnables, de rattacher les données à quelqu’un, et pas seulement l’existence d’une clé. La CNIL place la barre de l’anonymisation haut : c’est « un traitement qui consiste à utiliser un ensemble de techniques de manière à rendre impossible, en pratique, toute identification de la personne par quelque moyen que ce soit et de manière irréversible ». Et, pour le Comité européen de la protection des données (EDPB, selon son sigle anglais), « les données véritablement anonymisées ne sont plus considérées comme des données à caractère personnel ». (Sources : CNIL, 2020 ; EDPB, page « Anonymisation et pseudonymisation » ; consultés le 22 septembre 2026.)
| Pseudonymisé | Anonyme | Chiffré | |
|---|---|---|---|
| Rattachable à la personne ? | Oui, avec les informations supplémentaires conservées à part | Non, par qui que ce soit, compte tenu des moyens raisonnablement susceptibles d’être utilisés | Oui, pour qui détient la clé de déchiffrement |
| Donnée personnelle ? | En principe oui ; pour un destinataire sans moyens de réidentification, selon les circonstances, peut-être pas (CJUE, 2025) | Non | En principe oui : pour la CNIL, le chiffrement à clé secrète est une technique de pseudonymisation |
| Le RGPD s’applique-t-il ? | Oui, pour le responsable et pour quiconque peut réidentifier | Non (considérant 26) | Oui, au moins pour qui détient la clé |
(Sources : RGPD, considérant 26 ; CJUE, communiqué de presse n° 107/25 ; CNIL, 2022, pour le chiffrement ; et notre lecture. Consultés le 22 septembre 2026.)
Quand des données anonymisées le sont-elles vraiment ? « Les autorités de protection des données européennes définissent trois critères qui permettent de s’assurer qu’un jeu de données est véritablement anonyme », écrit la CNIL : l’individualisation (« il ne doit pas être possible d’isoler un individu dans le jeu de données »), la corrélation et l’inférence. Ils figurent déjà dans l’avis 05/2014 du G29, adopté le 10 avril 2014. (Sources : CNIL, 2020 ; G29, avis 05/2014, version française ; consultés le 22 septembre 2026.)
L’EDPB a adopté le 7 juillet 2026 des lignes directrices 02/2026 sur l’anonymisation, soumises à consultation publique jusqu’au 30 octobre 2026. Elles s’appuient elles aussi sur trois critères, que la CNIL formule ainsi : « pas d’individualisation des enregistrements, pas de corrélation, et pas d’inférence » (en anglais : no record isolation, no linkage, no inference). (Sources : CNIL, actualité du 9 juillet 2026 ; communiqué de l’EDPB du 8 juillet 2026, en anglais ; consultés le 22 septembre 2026.)
Le mot « anonymisation » s’emploie aussi au sens large : l’« anonymisation des actes » décrite par l’INPI (27 août 2025) consiste à diffuser une version des pièces « sans adresses personnelles », la version complète n’étant accessible qu’au greffe du tribunal de commerce. C’est une occultation dans un registre, pas une anonymisation au sens du RGPD. (Source : INPI, consulté le 22 septembre 2026.)
Les données pseudonymisées sont-elles des données personnelles ?
Pour le responsable qui conserve la table de correspondance (ou dispose d’autres moyens raisonnables d’identifier), oui. Dans son communiqué du 17 janvier 2025, l’EDPB écrit que les données pseudonymisées « restent des informations relatives à une personne physique identifiable et restent donc des données à caractère personnel », et précise : « si les données peuvent être reliées à une personne par le responsable du traitement ou par quelqu’un d’autre, elles restent des données personnelles ». La CNIL en tire la conséquence : leur traitement « reste intégralement soumis aux obligations du RGPD (définition d’une base légale, d’une durée de conservation, possibilité d’exercice des droits pour les personnes concernées […]) ». (Sources : EDPB, communiqué du 17 janvier 2025 ; CNIL, 2022 ; consultés le 22 septembre 2026.)
Pseudonymiser ne tient donc pas lieu de base légale et n’autorise pas, à lui seul, à partager les données : finalité, minimisation, contrat avec le destinataire, sécurité et éventuels transferts hors de l’Union restent à examiner.
L’arrêt SRB de la Cour de justice (C-413/23 P, 4 septembre 2025)
L’affaire part de la résolution de la Banco Popular Español, le 7 juin 2017. Le Conseil de résolution unique (CRU, ou SRB en anglais) a transmis à Deloitte, chargée d’évaluer les effets de la résolution, certains commentaires recueillis dans la procédure, « sous forme de données pseudonymisées ». En cause : l’obligation d’information du CRU. Saisie d’un pourvoi du Contrôleur européen de la protection des données, la Cour de justice a annulé l’arrêt du Tribunal — qui avait annulé la décision du Contrôleur — et lui a renvoyé l’affaire.
Sur le statut des données pseudonymisées, elle donne pourtant raison au Tribunal : elles « ne doivent pas être considérées comme constituant, en toute hypothèse et pour toute personne, des données à caractère personnel », car la pseudonymisation « peut, selon les circonstances de l’espèce, effectivement empêcher des personnes autres que le responsable du traitement d’identifier la personne concernée de telle manière que, pour elles, celle-ci n’est pas ou n’est plus identifiable ».
Sur l’obligation d’information, elle lui donne tort : « le caractère identifiable de la personne concernée doit être apprécié au moment de la collecte des données et du point de vue du responsable du traitement ». L’obligation d’information du CRU « s’appliquait en amont du transfert », que les commentaires soient ou non des données personnelles du point de vue de Deloitte. (Source : CJUE, communiqué de presse n° 107/25, 4 septembre 2025, consulté le 22 septembre 2026.)
La Cour appliquait le règlement (UE) 2018/1725, propre aux institutions et organes de l’Union, et non le RGPD ; l’EDPB tient néanmoins compte de l’arrêt dans ses lignes directrices 02/2026. (Sources : communiqué n° 107/25, note 1 ; CNIL, 9 juillet 2026 ; consultés le 22 septembre 2026.)
Quand la pseudonymisation ne suffit pas : la décision Criteo du Conseil d’État (4 mars 2026)
Criteo contestait l’amende de 40 millions d’euros prononcée contre elle le 15 juin 2023 par la formation restreinte de la CNIL. Par une décision du 4 mars 2026 (n° 482872, inédite au recueil Lebon), le Conseil d’État a rejeté la requête. Son considérant 11 fixe le critère d’une donnée « rendue anonyme par une pseudonymisation » :
Le considérant 12 l’applique. Criteo faisait valoir qu’elle attribue à chaque personne « un identifiant sous forme de pseudonyme, lié à l’adresse IP du terminal ». Le Conseil d’État relève que sont associés à cet identifiant « non seulement l’adresse IP elle-même, mais des données telles que l’emplacement géographique lié à cette adresse IP, l’identifiant du terminal, les identifiants, propres aux partenaires de Criteo, des personnes se rendant sur le site de ces partenaires, ainsi que de très nombreux éléments liés à l’activité de navigation de ces personnes […] ». Quant à l’absence de clé : « si la société Criteo soutient qu’elle ne dispose pas de clé de réidentification permettant d’identifier, à partir du seul identifiant Criteo, les personnes concernées, il résulte de l’instruction que […] l’identification de certaines personnes ne serait pas techniquement impossible ».
Le Conseil d’État conclut que, « pour le responsable du traitement qu’est la société Criteo, une partie au moins des très nombreuses personnes concernées étaient identifiables, par des moyens n’impliquant pas un effort démesuré en termes de temps, de coût et de main d’oeuvre, sans que la société requérante puisse utilement se prévaloir de ce qu’une telle identification ne présenterait pour elle aucun intérêt ». (Sources : Conseil d’État, 10e et 9e chambres réunies, 4 mars 2026, n° 482872, Sté Criteo, considérants 1, 11 et 12 ; décision signalée par Lefebvre Dalloz le 24 juin 2026 ; consultés le 22 septembre 2026.)
À notre lecture, les deux décisions ne se contredisent pas : la Cour de justice raisonne sur un destinataire sans moyens de réidentification, le Conseil d’État sur un acteur qui détient, autour du pseudonyme, adresse IP, localisation et activité de navigation. Dans les deux cas comptent les moyens d’identification dont dispose l’acteur concerné, pas seulement la clé. Pour le Conseil d’État, l’absence d’intérêt à identifier n’y change rien. Transposé à un document : un <PERSON_1> entouré d’une date de naissance, d’une ville et d’un poste peut laisser la personne identifiable.
Lignes directrices 01/2025 de l’EDPB sur la pseudonymisation : où en est-on ?
L’EDPB a adopté ses lignes directrices 01/2025 sur la pseudonymisation lors de sa plénière de janvier 2025 (communiqué du 17 janvier). La consultation publique, annoncée jusqu’au 28 février 2025, a été close le 14 mars 2025. Au 22 septembre 2026, aucune version définitive n’a été annoncée : les actualités liées de la page thématique de l’EDPB n’en signalent aucune. (Sources : communiqué du 17 janvier 2025 ; page de la consultation, en anglais ; page thématique de l’EDPB ; consultés le 22 septembre 2026.)
Selon le communiqué, la pseudonymisation peut « faciliter l’utilisation d’intérêts légitimes comme base juridique [article 6, paragraphe 1, point f), du RGPD], pour autant que toutes les autres exigences du RGPD soient respectées », contribuer à la compatibilité avec la finalité initiale (article 6, paragraphe 4) et aider à respecter les articles 5 (principes), 25 (protection dès la conception et par défaut) et 32 (sécurité).
Où le RGPD mentionne la pseudonymisation
Outre la définition et les considérants, le règlement la nomme aussi dans ces cinq articles :
| Article | Contexte | Texte |
|---|---|---|
| Art. 6, § 4, point e) | Traitement pour une autre finalité : compatibilité avec la finalité initiale | « de l’existence de garanties appropriées, qui peuvent comprendre le chiffrement ou la pseudonymisation » |
| Art. 25, § 1 | Protection des données dès la conception (privacy by design) | « des mesures techniques et organisationnelles appropriées, telles que la pseudonymisation, qui sont destinées à mettre en œuvre les principes relatifs à la protection des données […] de façon effective » |
| Art. 32, § 1, point a) | Sécurité du traitement | « la pseudonymisation et le chiffrement des données à caractère personnel » |
| Art. 40, § 2, point d) | Codes de conduite | « la pseudonymisation des données à caractère personnel » |
| Art. 89, § 1 | Archives dans l’intérêt public, recherche scientifique ou historique, statistiques | « Ces mesures peuvent comprendre la pseudonymisation, dans la mesure où ces finalités peuvent être atteintes de cette manière. » |
(Source : RGPD, texte hébergé par la CNIL, consulté le 22 septembre 2026.)
L’article 25 (privacy by design) prend la pseudonymisation pour exemple ; l’article 32 la cite, avec le chiffrement, parmi les mesures de sécurité. Aucun de ces textes n’en fait une obligation générale : « telles que » (article 25) et « peuvent comprendre » (articles 6 et 89) laissent le choix des mesures au responsable du traitement, et le considérant 28, après avoir noté qu’elle « peut réduire les risques pour les personnes concernées », précise que son introduction explicite « ne vise pas à exclure toute autre mesure de protection des données ». Pour la CNIL, c’est « une des mesures recommandées par le RGPD pour limiter les risques ». (Sources : RGPD, considérant 28, texte français sur privacy-regulation.eu, miroir non officiel ; CNIL, 2020 ; consultés le 22 septembre 2026.)
Pseudonymiser un document avant de l’envoyer à une IA
Un contrat à résumer, un compte rendu médical à expliquer : si le texte part vers un assistant d’IA avec les noms en clair, le fournisseur reçoit les données personnelles du client ou du patient. Avec des marqueurs cohérents et une table de correspondance restée sur le poste, on retrouve le schéma de l’article 4, point 5 : le fournisseur reçoit des marqueurs, l’information supplémentaire reste à part.
Où garder la table ? L’article 4, point 5, exige qu’elle soit conservée séparément et protégée ; il ne dit pas qui doit la détenir. Notre recommandation : la garder en local, au cabinet ou dans l’entreprise, et ne jamais la joindre au texte envoyé, ce qui remettrait au destinataire les moyens de réidentifier. La CNIL rappelle aussi que « l’inversion non autorisée de la pseudonymisation peut constituer une violation de données personnelles », à notifier à l’autorité de protection des données si elle est susceptible d’entraîner un risque pour les droits et libertés des personnes. (Source : CNIL, 2022, consulté le 22 septembre 2026.)
À la main, sur un long dossier, un nom finit par passer inaperçu dans une note de bas de page, ou la même personne change d’initiales d’un paragraphe à l’autre.
La marche à suivre pas à pas : anonymiser un document avant ChatGPT. Pour une pièce à produire, où il faut supprimer et non remplacer : caviarder un document. Pour les avocats : IA et secret professionnel de l’avocat.
Pseudonymiser en local avec Occlira
Occlira, application de bureau pour Windows et macOS (Apple Silicon), travaille en local sur vos fichiers, avec deux outils que le RGPD ne range pas dans la même catégorie.
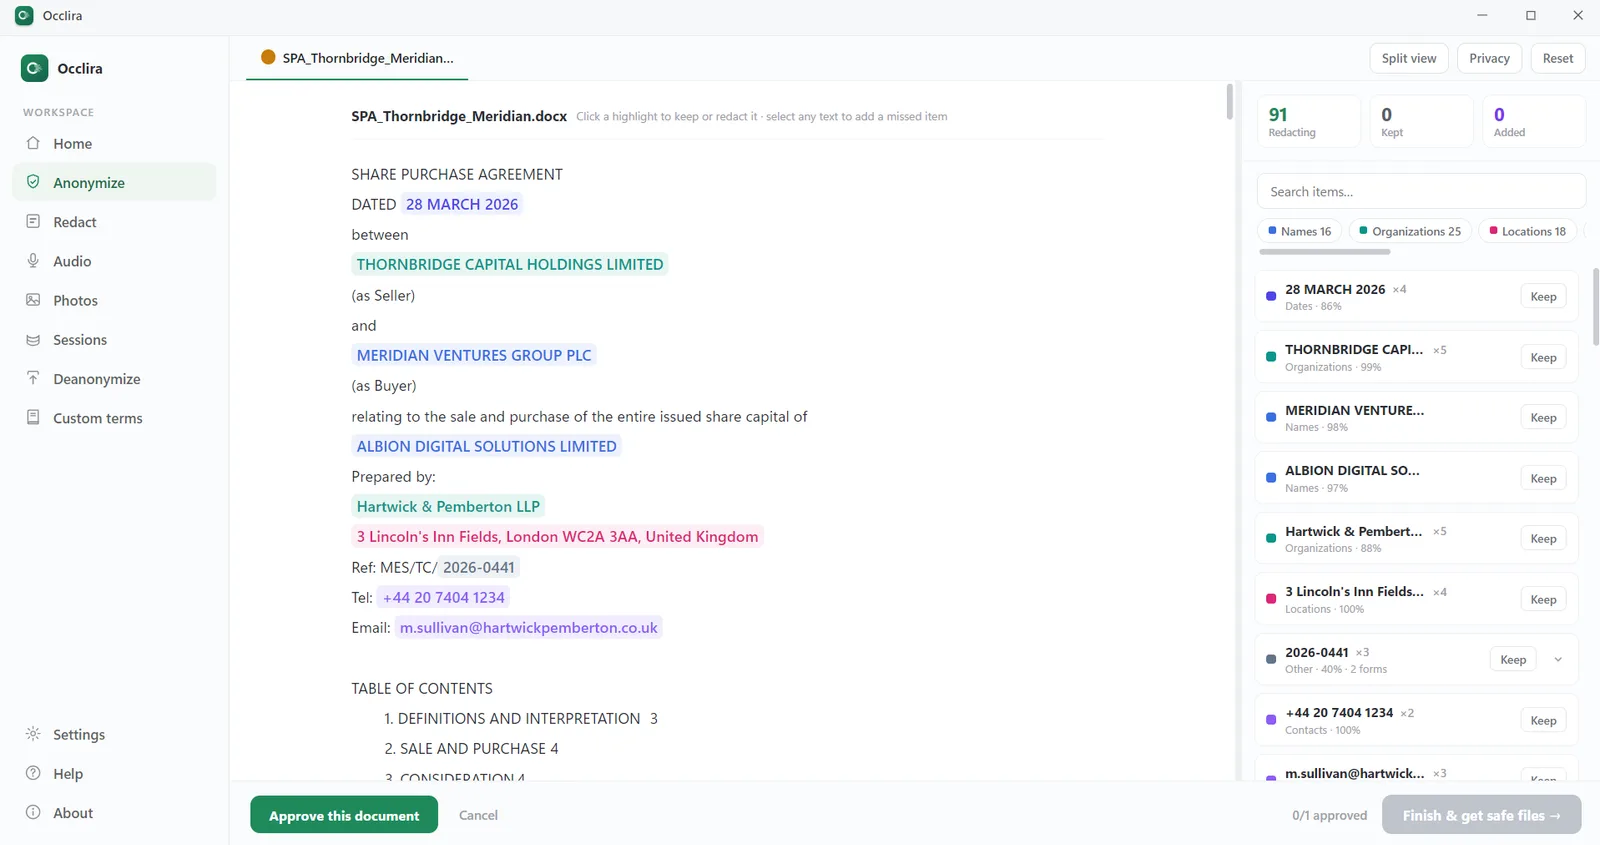
Le mode Anonymize réalise une pseudonymisation au sens de l’article 4, point 5. La détection (un modèle local et des règles à base d’expressions régulières) propose les identifiants avec un score de confiance ; vous les vérifiez et ajoutez ce qui manque en le sélectionnant dans le texte, et chaque valeur devient un marqueur cohérent
comme <PERSON_1>. Un fichier Word (DOCX) ou Excel (XLSX) reste dans son format, mise en forme conservée ;
commentaires, suivi des modifications et propriétés du document sont nettoyés. Un PDF, un e-mail (EML) ou une image,
scans compris (OCR sur l’appareil), ressort en .txt ; le bouton « Copy anonymized text » en copie le texte. La table
de correspondance reste sur votre poste (permissions 0600) et s’efface après 7 jours par défaut, durée
configurable. La réponse de l’IA, enregistrée dans un fichier, passe par Deanonymize, qui en
produit une copie _restored avec les vraies valeurs.
Redact, pour les PDF et les images de texte, supprime au lieu de remplacer. Dans l’aperçu, chaque terme repéré a son cadre : vous le désactivez, ajoutez un terme oublié ou tracez une zone à la main. Les zones sont gravées dans un nouveau fichier nom_redacted.pdf composé uniquement d’images, sans couche texte, ni métadonnées, ni annotations d’origine ; l’original reste intact. L’opération est irréversible, sans table de correspondance ; un contrôle final vérifie qu’aucun terme n’est encore extractible (indicatif sur un scan), et le texte n’est plus sélectionnable. Redact retire les données de cette copie, sans en faire un document « anonyme » au sens du considérant 26 : le contexte restant doit être apprécié.
La détection tourne hors ligne ; l’application ne se connecte que pour activer la licence (via Polar), télécharger son modèle et vérifier les mises à jour. Occlira aide à pseudonymiser avec méthode ; il ne garantit pas la conformité au RGPD et ne remplace pas l’analyse du responsable du traitement.
Questions fréquentes
La pseudonymisation est le traitement qui empêche d’attribuer des données à une personne précise sans informations supplémentaires, comme une table de correspondance ou une clé. C’est la définition de l’article 4, point 5, du RGPD, qui pose deux conditions : ces informations sont conservées séparément et protégées par des mesures techniques et organisationnelles.
Des données pseudonymisées peuvent encore être rattachées à la personne grâce à des informations conservées à part : ce sont en principe des données personnelles, et le RGPD s’applique. L’anonymisation cherche à rendre l’identification impossible avec les moyens raisonnablement utilisables par quiconque ; si elle y parvient, le règlement ne s’applique plus.
En principe, oui : le considérant 26 et l’EDPB les traitent comme des informations sur une personne identifiable, puisque quelqu’un peut les rattacher à elle. En 2025, la Cour de justice a admis que, selon les circonstances, elles peuvent ne pas l’être pour un destinataire sans moyens de réidentification. Pour le responsable qui garde la table, elles le restent.
Non, si l’anonymisation est réelle : le considérant 26 écarte du règlement les données rendues anonymes de telle manière que la personne ne soit plus identifiable. Le seuil est élevé. Pour la CNIL, l’identification doit devenir impossible en pratique, de manière irréversible ; pour le Conseil d’État, une donnée pseudonymisée n’est anonyme que si le risque d’identification est insignifiant.
Pas en règle générale. Le RGPD la cite comme exemple de mesure de protection des données dès la conception (article 25) et, avec le chiffrement, parmi les mesures de sécurité (article 32). Il revient au responsable du traitement de choisir des mesures appropriées : la pseudonymisation en est une, pas la seule.
Oui : la CNIL range le chiffrement à clé secrète et la fonction de hachage parmi les techniques de pseudonymisation. Un hachage sans clé, appliqué à des valeurs prévisibles, peut être reconstitué en hachant toutes les valeurs possibles. Aucun des deux ne rend les données anonymes à lui seul : le résultat est une donnée pseudonymisée, donc en principe personnelle.
Le 4 septembre 2025 (C-413/23 P), la Cour a annulé l’arrêt du Tribunal. L’arrêt applique le règlement 2018/1725 (institutions de l’Union), non directement le RGPD. La Cour confirme que des données pseudonymisées ne sont pas personnelles dans tous les cas ni pour toute personne : selon les circonstances, pas pour un destinataire sans moyens de réidentifier. Pour l’obligation d’information, l’identifiabilité s’apprécie à la collecte, du point de vue du responsable.
Le 4 mars 2026 (n° 482872), il a rejeté la requête de Criteo contre l’amende de 40 millions d’euros de la CNIL. Une donnée n’est rendue anonyme par pseudonymisation que si le risque d’identification est insignifiant. L’identifiant Criteo était associé à l’adresse IP, à la localisation et à l’activité de navigation : bien que Criteo dise ne pas détenir de clé de réidentification, identifier certaines personnes n’était pas techniquement impossible.
L’article 4, point 5, ne désigne personne : il exige que ces informations soient conservées séparément et protégées. Notre recommandation : que la table reste chez le responsable du traitement et ne voyage jamais avec les données. Envoyée avec la copie, elle permettrait au destinataire de remettre les vrais noms à la place des marqueurs.
Ce n’est pas la seule mesure possible, mais elle réduit ce que reçoit le fournisseur : des marqueurs au lieu des noms et des numéros, la table restant chez vous. Elle ne rend pas le traitement anonyme et ne dispense pas du reste du RGPD ; dates, lieux et fonctions restés dans le texte sont à relire avant l’envoi.
Pour aller plus loin : PII et données personnelles · caviarder Word, PDF et Excel · la checklist IA de la CNIL
Essayez sur l’un de vos documents
Gratuit pendant 14 jours sous Windows et macOS (Apple Silicon). Licence à paiement unique à partir de 149 € par poste, sans abonnement.