Pseudonymisierung von Daten: Definition, Beispiele und Unterschied zur Anonymisierung (DSGVO, 2026)
Pseudonymisierung von Daten bedeutet, dass sich Daten ohne gesondert aufbewahrte Zusatzinformationen (etwa eine Zuordnungstabelle) keiner bestimmten Person mehr zuordnen lassen – meist, indem Namen und Kennungen durch Codes ersetzt werden. Die Zusatzinformationen müssen technisch und organisatorisch geschützt sein (Art. 4 Nr. 5 DSGVO). Anders als anonyme Daten bleiben pseudonymisierte Daten mit diesen Informationen zuordenbar und grundsätzlich personenbezogen. Für Empfänger ohne Mittel zur Re-Identifizierung können sie laut EuGH (2025) je nach den Umständen keine personenbezogenen Daten sein. Allgemeine Information, keine Rechtsberatung.
Pseudonymisierung nach DSGVO: die Definition in Art. 4 Nr. 5
„Pseudonymisierung“ die Verarbeitung personenbezogener Daten in einer Weise, dass die personenbezogenen Daten ohne Hinzuziehung zusätzlicher Informationen nicht mehr einer spezifischen betroffenen Person zugeordnet werden können, sofern diese zusätzlichen Informationen gesondert aufbewahrt werden und technischen und organisatorischen Maßnahmen unterliegen, die gewährleisten, dass die personenbezogenen Daten nicht einer identifizierten oder identifizierbaren natürlichen Person zugewiesen werden;
(Quelle: DSGVO, Art. 4, deutscher Wortlaut auf dsgvo-gesetz.de, abgerufen am 22. September 2026.)
Die zusätzlichen Informationen sind typischerweise eine Zuordnungstabelle oder ein Schlüssel. Technisch beschreibt die Artikel-29-Datenschutzgruppe den Vorgang so: „Im Zuge der Pseudonymisierung wird ein Merkmal (in der Regel ein einzigartiges Merkmal) in einem Datensatz durch ein anderes ersetzt.“ (Quelle: Artikel-29-Datenschutzgruppe, Stellungnahme 5/2014 zu Anonymisierungstechniken (WP 216), S. 24, abgerufen am 22. September 2026.) Was überhaupt als personenbezogenes Datum gilt, erklärt unser Leitfaden „Was sind personenbezogene Daten?“.
Nach Erwägungsgrund 28 kann die Pseudonymisierung „die Risiken für die betroffenen Personen senken“ und bei den Datenschutzpflichten helfen; andere Maßnahmen auszuschließen, ist „nicht beabsichtigt“. Erwägungsgrund 29 will Anreize setzen: Pseudonymisierung, die eine allgemeine Analyse zulässt, soll „bei demselben Verantwortlichen möglich sein“, wenn er die nötigen Maßnahmen getroffen hat und die zusätzlichen Informationen „gesondert aufbewahrt werden“. (Quellen: DSGVO, Erwägungsgrund 28 und Erwägungsgrund 29, abgerufen am 22. September 2026.)
Beispiele für Pseudonymisierung: Verfahren und Dokumente
ENISA beschreibt im Bericht „Pseudonymisation techniques and best practices“ (November 2019) fünf Verfahren: Zähler, Zufallszahlengenerator, kryptografische Hashfunktion, Message Authentication Code (MAC) und Verschlüsselung. Die Leitlinien 01/2025 des Europäischen Datenschutzausschusses (EDSA, englisch EDPB) unterscheiden zwei Klassen gängiger Ersetzungsverfahren: kryptografische Algorithmen und Zuordnungstabellen. Ein MAC wie HMAC ist ein Hash mit geheimem Schlüssel; ENISA hält ihn in der Regel für robust, solange der Schlüssel nicht kompromittiert ist. (Quellen: ENISA, Pseudonymisation techniques and best practices, Abschnitt 5.1; EDSA, Guidelines 01/2025, Rn. 87; beide auf Englisch, abgerufen am 22. September 2026.)
Drei Dokumente und eine Datenbankzeile, mit erfundenen Daten:
| Dokument | Original | Pseudonymisierte Kopie | Was Sie noch prüfen sollten |
|---|---|---|---|
| Schriftsatz | Klage der Sabine Krüger, geb. 12.03.1971 in Kassel, gegen die Hartmann Bau GmbH, Az. 3 O 412/25 | Klage der <PERSON_1>, geb. <DATE_1> in <LOCATION_1>, gegen die <ORG_1>, Az. <ID_1> | Zeugen, Gutachter und das Aktenzeichen in Kopf- und Fußzeilen |
| Arztbrief | Jonas Weber, geb. 14.08.1985, Lindenstraße 12, Leipzig. Diagnose: Diabetes mellitus Typ 2 | <PERSON_1>, geb. <DATE_1>, <LOCATION_1>. Diagnose: Diabetes mellitus Typ 2 | Seltene Diagnosen, Behandlungsdaten, Angehörige im Fließtext |
| Rechnung | Rechnung Nr. 118 an Kanzlei Brandt, IBAN DE00 0000 0000 0000 0000 00, 3.450,00 € | Rechnung Nr. 118 an <ORG_1>, IBAN <IBAN_1>, 3.450,00 € | Nummer und Betrag führen über die Buchhaltung zum Mandanten |
| Kundendatenbank (eine Zeile) | Anna Becker; 05.11.1990; Bamberg; Umsatz 2025: 1.200 € | 000123 (Zähler) oder ein HMAC-Wert; 05.11.1990; Bamberg; Umsatz 2025: 1.200 € | Geburtsdatum und Wohnort können zusammen genügen, um die Person zu erkennen |
Alle Angaben und Platzhalterbezeichnungen sind Beispiele; die Prüfhinweise in der letzten Spalte sind unsere Einschätzung.
Nur den Namen zu ersetzen, genügt nicht: Art. 4 Nr. 1 DSGVO nennt neben dem Namen ausdrücklich die „Kennnummer“ als Kennung, und bleiben Kundennummer, Aktenzeichen oder Anschrift stehen, lässt sich das Dokument oft ohne zusätzliche Informationen zuordnen. Schwach ist auch ein Hash vorhersehbarer Werte ohne Schlüssel, denn man kann alle möglichen Werte hashen und abgleichen. Die Artikel-29-Datenschutzgruppe zeigt das an einem Datenbestand, der „durch Hashen der Landes-ID pseudonymisiert“ wurde, der EDSA am SHA-256-Hash eines Namens. (Quellen: DSGVO, Art. 4 Nr. 1; WP 216, S. 24; EDSA, Guidelines 01/2025, Fußnote 23; abgerufen am 22. September 2026.)
Pseudonymisierung und Anonymisierung: der Unterschied
Der Unterschied zwischen Pseudonymisierung und Anonymisierung liegt in der Identifizierbarkeit, und an ihr hängt, ob die DSGVO überhaupt gilt. Erwägungsgrund 26 regelt beides in einem Zug:
Einer Pseudonymisierung unterzogene personenbezogene Daten, die durch Heranziehung zusätzlicher Informationen einer natürlichen Person zugeordnet werden könnten, sollten als Informationen über eine identifizierbare natürliche Person betrachtet werden. Um festzustellen, ob eine natürliche Person identifizierbar ist, sollten alle Mittel berücksichtigt werden, die von dem Verantwortlichen oder einer anderen Person nach allgemeinem Ermessen wahrscheinlich genutzt werden, um die natürliche Person direkt oder indirekt zu identifizieren, wie beispielsweise das Aussondern. Bei der Feststellung, ob Mittel nach allgemeinem Ermessen wahrscheinlich zur Identifizierung der natürlichen Person genutzt werden, sollten alle objektiven Faktoren, wie die Kosten der Identifizierung und der dafür erforderliche Zeitaufwand, herangezogen werden, wobei die zum Zeitpunkt der Verarbeitung verfügbare Technologie und technologische Entwicklungen zu berücksichtigen sind. Die Grundsätze des Datenschutzes sollten daher nicht für anonyme Informationen gelten, d.h. für Informationen, die sich nicht auf eine identifizierte oder identifizierbare natürliche Person beziehen, oder personenbezogene Daten, die in einer Weise anonymisiert worden sind, dass die betroffene Person nicht oder nicht mehr identifiziert werden kann.
(Quelle: DSGVO, Erwägungsgrund 26, deutscher Wortlaut, abgerufen am 22. September 2026.)
Maßgeblich ist die Zuordenbarkeit, nicht die Umkehrbarkeit einer Rechenoperation: Einen HMAC-Wert kann man, solange der Schlüssel sicher ist, nicht zurückrechnen; wer den Schlüssel hat, berechnet ihn aber aus dem Ausgangswert neu und kann so zuordnen. Das bleibt Pseudonymisierung. Der EDSA beschreibt sie auf seiner deutschen Themenseite als „eine Schutzmaßnahme, die die Verknüpfbarkeit von Daten mit einer bestimmten Person verringert, ohne diese Verbindung vollständig aufzuheben“; Anonymisierung verändere Daten so, „dass sie keiner Person mehr zugeordnet werden können“. (Quellen: ENISA, 2019, Abschnitt 5.1.4 (MAC); WP 216, S. 25; EDSA, Themenseite „Anonymisierung/Pseudonymisierung“; abgerufen am 22. September 2026.)
Pseudonymisiert vs. anonymisiert vs. verschlüsselt
| Pseudonymisiert | Anonym | Verschlüsselt | |
|---|---|---|---|
| Einer Person zuordenbar? | Ja, mit den gesondert aufbewahrten zusätzlichen Informationen | Nein, auch nicht mit den Mitteln, die der Verantwortliche oder eine andere Person nach allgemeinem Ermessen wahrscheinlich nutzt | Ja, für jeden, der den Schlüssel hat |
| Personenbezogene Daten? | Grundsätzlich ja; für einen Empfänger ohne Mittel zur Re-Identifizierung je nach den Umständen nicht (EuGH, 2025) | Nein | Grundsätzlich ja, wie pseudonymisierte Daten: Verschlüsselung kann ein Werkzeug der Pseudonymisierung sein |
| Gilt die DSGVO? | Für den Verantwortlichen grundsätzlich ja; bei anderen Empfängern je nachdem, ob ihnen Mittel zur Identifizierung, die nach allgemeinem Ermessen wahrscheinlich genutzt werden, zur Verfügung stehen | Nein (Erwägungsgrund 26) | Grundsätzlich ja für den, der den Schlüssel hat oder realistisch erlangen kann |
(Quellen: DSGVO, Erwägungsgrund 26; EuGH, Pressemitteilung Nr. 107/25. Zur Verschlüsselung: gemeinsames Papier der spanischen Aufsichtsbehörde AEPD und des Europäischen Datenschutzbeauftragten (EDSB) über zehn Missverständnisse zur Anonymisierung (2021, auf Englisch): „Encryption is not an anonymisation technique, but it can be a powerful pseudonymisation tool.“ Abgerufen am 22. September 2026.)
Daten anonymisieren: Wann gelten Daten als anonym?
Wer Daten anonymisieren will, muss mehr tun, als Namen zu ersetzen. Die Artikel-29-Datenschutzgruppe beschrieb in ihrer Stellungnahme 5/2014 drei Risiken: „Herausgreifen (singling out)“, also Datensätze zu isolieren, „welche die Identifizierung einer Person ermöglichen“ (in Erwägungsgrund 26 „das Aussondern“); „Verknüpfbarkeit“ von mindestens zwei Datensätzen derselben Person; und „Inferenz“, den Wert eines Merkmals „mit einer signifikanten Wahrscheinlichkeit“ aus anderen abzuleiten. Die Leitlinien 02/2026 des EDSA zur Anonymisierung, Anfang Juli 2026 angenommen (Pressemitteilung vom 8. Juli) und bis zum 30. Oktober 2026 in öffentlicher Konsultation, machen daraus drei Kriterien: „no record isolation“, „no linkage“ und „no inference“ (auf Englisch). Sind alle drei erfüllt, können die Daten als anonym gelten; ob sie es sind, kann nach dem EDSA aber von Stelle zu Stelle verschieden sein („may vary from one entity to another“). (Quellen: WP 216, S. 13; EDSA, Pressemitteilung vom 8. Juli 2026, auf Englisch zitiert, weil die deutsche Fassung nach Angabe des EDSA eine automatisierte Übersetzung ist; Konsultationsseite 02/2026; abgerufen am 22. September 2026.)
Zur Anonymisierung von Daten gibt es auch Orientierungshilfen aus Deutschland. Das Positionspapier des Bundesbeauftragten für den Datenschutz und die Informationsfreiheit (BfDI) zur Anonymisierung (Stand 29. Juni 2020, mit Blick auf die TK-Branche) leitet die Anonymisierung aus der Datenminimierung ab: Genügt die Analyse von Datensätzen, „deren abstrakter Gehalt erhalten bleibt, der Personenbezug jedoch aufgehoben wird“, seien die Daten nach Art. 5 Abs. 1 lit. c DSGVO „nur in anonymisierter Form zu verarbeiten“. Ein Vorgehensmodell bietet der „Praxisleitfaden zum Anonymisieren personenbezogener Daten“, den Rolf Schwartmann und weitere Autoren im Dezember 2022 im Auftrag der Stiftung Datenschutz vorgelegt haben; 2023 folgte eine Textsammlung zur Anonymisierung und Pseudonymisierung. (Quellen: BfDI, Positionspapier zur Anonymisierung (PDF); Stiftung Datenschutz, Praxisleitfaden (PDF) und Übersichtsseite „Anonymisierung von Daten“; abgerufen am 22. September 2026.)
Sind pseudonymisierte Daten personenbezogene Daten?
Grundsätzlich ja. Nach der deutschen Pressemitteilung des EDSA vom 17. Januar 2025 bleiben sie personenbezogene Daten, „wenn die Daten von dem für die Verarbeitung Verantwortlichen oder einer anderen Person mit einer Person verknüpft werden können“. Ebenso das BfDI-Positionspapier: „Bei den pseudonymisierten Daten handelt es sich um personenbezogene Daten, auf die das Datenschutzrecht anwendbar ist“. Für einen Empfänger, der nur die Kopie erhält, hat der EuGH 2025 differenziert. (Quellen: EDSA, Pressemitteilung vom 17. Januar 2025; BfDI, Positionspapier zur Anonymisierung, S. 4; abgerufen am 22. September 2026.)
EuGH-Urteil zu pseudonymisierten Daten: EDSB/SRB (C-413/23 P, 4. September 2025)
Nach der Abwicklung von Banco Popular Español übermittelte der Einheitliche Abwicklungsausschuss (Single Resolution Board, SRB) „bestimmte Stellungnahmen als pseudonymisierte Daten an Deloitte“, eine Wirtschaftsprüfungs- und Beratungsgesellschaft, die die Folgen der Abwicklung für Anteilseigner und Gläubiger bewerten sollte. Mehrere betroffene Anteilseigner und Gläubiger beschwerten sich beim Europäischen Datenschutzbeauftragten (EDSB), weil der SRB sie nicht über die Übermittlung informiert habe. Das Gericht der EU erklärte die Entscheidung des EDSB für nichtig; auf das Rechtsmittel des EDSB hob der Gerichtshof dieses Urteil am 4. September 2025 auf und verwies die Sache zurück.
| Pressemitteilung Nr. 107/25 (Wortlaut) | Was das heißt (unsere Zusammenfassung) |
|---|---|
| „… bestätigt der Gerichtshof die Feststellung des Gerichts, dass pseudonymisierte Daten für die Zwecke der Anwendung der Verordnung 2018/1725 nicht in jedem Fall und für jede Person als personenbezogene Daten zu betrachten sind.“ | Pseudonymisierte Daten sind nicht immer und nicht für jeden personenbezogen. |
| „… dass die Pseudonymisierung – je nach den Umständen des Falles – andere Personen als den Verantwortlichen tatsächlich daran hindern kann, die betroffene Person zu identifizieren, so dass diese für sie nicht oder nicht mehr identifizierbar ist.“ | Je nach Fall kann die Pseudonymisierung Dritte wirksam an der Identifizierung hindern; für sie ist die Person dann nicht (mehr) identifizierbar. |
| „Folglich ist die Identifizierbarkeit der betroffenen Person aus der Sicht des Gerichtshofs zu dem Zeitpunkt des Erhebens der Daten und aus der Sicht des Verantwortlichen zu beurteilen. Die dem SRB obliegende Informationspflicht entstand somit vor der Übermittlung der fraglichen Stellungnahmen …“ | Für die Pflicht, die Betroffenen zu informieren, zählen der Zeitpunkt der Erhebung und die Sicht des Verantwortlichen: Sie bestand schon vor der Übermittlung, unabhängig davon, ob die Stellungnahmen aus Sicht von Deloitte personenbezogen waren. |
(Quelle: EuGH, Pressemitteilung Nr. 107/25 vom 4. September 2025, abgerufen am 22. September 2026.)
Angewandt hat der Gerichtshof nicht die DSGVO, sondern die Verordnung (EU) 2018/1725 für die Organe, Einrichtungen und sonstigen Stellen der Union; der EDSA berücksichtigt das Urteil aber ausdrücklich in seinen Leitlinien 02/2026. Für den Verantwortlichen, der die Zuordnung kennt, macht das Urteil die Daten nicht anonym: Die Aussage gilt für „andere Personen als den Verantwortlichen“ und für sie auch nur „je nach den Umständen des Falles“. (Quellen: EuGH, Pressemitteilung Nr. 107/25, Fußnote 1; EDSA, Pressemitteilung vom 8. Juli 2026, auf Englisch; abgerufen am 22. September 2026.)
EDSA-Leitlinien 01/2025 zur Pseudonymisierung: Inhalt und Stand
Der EDSA hat die Leitlinien in seiner 101. Plenarsitzung am 16. Januar 2025 einstimmig angenommen und am 17. Januar per Pressemitteilung vorgestellt. Die öffentliche Konsultation war bis zum 28. Februar 2025 angekündigt und endete am 14. März 2025. Eine endgültige Fassung ist bis zum 22. September 2026 nicht erschienen: Das PDF trägt weiter den Vermerk „Adopted – version for public consultation“, und die EDSA-Themenseite meldet keine abschließende Annahme. Laut Protokoll wollte der EDSA prüfen, ob das damals anhängige Verfahren C-413/23 P eine Überarbeitung erfordert; das Urteil kam im September 2025. (Quellen: Protokoll der 101. Plenarsitzung; Pressemitteilung vom 17. Januar 2025; Konsultationsseite; PDF der Leitlinien; EDSA-Themenseite; abgerufen am 22. September 2026.)
Laut der deutschen Pressemitteilung kann Pseudonymisierung „die Nutzung berechtigter Interessen als Rechtsgrundlage erleichtern (Art. 6 Abs. 1 lit. f DSGVO), sofern alle anderen Anforderungen der DSGVO erfüllt sind“, zur Vereinbarkeit mit dem ursprünglichen Zweck beitragen (Art. 6 Abs. 4) und bei Grundsätzen, Technikgestaltung und Sicherheit helfen (Art. 5, 25 und 32).
Den vom Verantwortlichen festgelegten Kontext, in dem die Zuordnung zu bestimmten Personen ausgeschlossen sein soll, nennen die (nur englischen) Leitlinien „pseudonymisation domain“ (eigene Übersetzung: Pseudonymisierungsdomäne). Bei einem Dokument für eine KI gehören dazu aus unserer Sicht der Anbieter, die Personen mit Zugriff und deren Mittel; das ist im Einzelfall festzulegen.
Wo DSGVO und BDSG die Pseudonymisierung nennen
Neben der Definition taucht die Pseudonymisierung in diesen Vorschriften auf:
| Vorschrift | Zusammenhang | Wortlaut |
|---|---|---|
| Art. 6 Abs. 4 lit. e DSGVO | Vereinbarkeit einer Weiterverarbeitung mit dem ursprünglichen Zweck | „das Vorhandensein geeigneter Garantien, wozu Verschlüsselung oder Pseudonymisierung gehören kann“ |
| Art. 25 Abs. 1 DSGVO | Datenschutz durch Technikgestaltung (Privacy by Design) | „geeignete technische und organisatorische Maßnahmen – wie z. B. Pseudonymisierung –, die dafür ausgelegt sind, die Datenschutzgrundsätze wie etwa Datenminimierung wirksam umzusetzen“ |
| Art. 32 Abs. 1 lit. a DSGVO | Sicherheit der Verarbeitung | „die Pseudonymisierung und Verschlüsselung personenbezogener Daten“ |
| Art. 40 Abs. 2 lit. d DSGVO | Verhaltensregeln | „Pseudonymisierung personenbezogener Daten“ |
| Art. 89 Abs. 1 DSGVO | Archiv-, Forschungs- und Statistikzwecke | „Zu diesen Maßnahmen kann die Pseudonymisierung gehören, sofern es möglich ist, diese Zwecke auf diese Weise zu erfüllen.“ |
| § 22 Abs. 2 Nr. 6 BDSG | Besondere Kategorien personenbezogener Daten (Art. 9 Abs. 1 DSGVO) | „Pseudonymisierung personenbezogener Daten“, eine der Schutzmaßnahmen, die nach Abs. 2 „insbesondere“ in Betracht kommen |
| § 27 Abs. 3 BDSG | Forschung und Statistik mit besonderen Kategorien | Nennt das Wort nicht; ergänzt § 22 Abs. 2 und verlangt Anonymisierung, sobald der Zweck es erlaubt und keine berechtigten Interessen der Betroffenen entgegenstehen; bis dahin getrennte Speicherung der Zuordnungsmerkmale |
(Quellen: DSGVO, deutscher Wortlaut auf dsgvo-gesetz.de; BDSG auf gesetze-im-internet.de, jeweils in der Tabelle verlinkt; abgerufen am 22. September 2026.)
Art. 32 Abs. 1 lit. a nennt die Pseudonymisierung und die Verschlüsselung als mögliche Maßnahmen; eine allgemeine Pflicht begründen die Vorschriften aber nicht: „wie z. B.“ (Art. 25), „kann … gehören“ (Art. 89), „insbesondere“ (§ 22 BDSG) und Erwägungsgrund 28 lassen Raum für andere Maßnahmen. Konkret wird § 27 Abs. 3 BDSG: Bei Forschungsdaten besonderer Kategorien sind die Zuordnungsmerkmale bis zur Anonymisierung „gesondert zu speichern“.
Wenn Pseudonymisierung nicht reicht: Re-Identifizierung
Pseudonymisierung stellt nach der Artikel-29-Datenschutzgruppe „eine sinnvolle Sicherheitsmaßnahme, aber kein Anonymisierungsverfahren dar“; die Person kann „nach wie vor mit großer Wahrscheinlichkeit indirekt identifiziert werden“. (Quelle: WP 216, S. 24, abgerufen am 22. September 2026.)
AOL, 2006. Die Artikel-29-Datenschutzgruppe nennt den Fall als „typisches Beispiel für die Fehleinschätzungen bezüglich der Pseudonymisierung“: Veröffentlicht wurde eine Datenbank mit „20 Mio. Suchwörtern“ von „etwa 650 000 Nutzern“; als einzige Schutzmaßnahme wurde „die Nutzer-ID durch einen numerischen Wert ersetzt“. Die New York Times verfolgte die Datenspur des Nutzers „AOL Searcher No. 4417749“ bis zu einer 62-jährigen Witwe in Lilburn, Georgia. (Quellen: WP 216, S. 12; M. Barbaro und T. Zeller Jr., „A Face Is Exposed for AOL Searcher No. 4417749“, New York Times, 9. August 2006, vom EFF archivierte Kopie; abgerufen am 22. September 2026.)
Drei Merkmale, dann fünfzehn. Latanya Sweeney (Carnegie Mellon University, 2000) ermittelte, dass sich 87 % der US-Bevölkerung (216 von 248 Millionen Menschen) nach ihren Angaben allein über fünfstellige Postleitzahl, Geschlecht und Geburtsdatum wahrscheinlich eindeutig bestimmen ließen. Rocher, Hendrickx und de Montjoye (Nature Communications, 2019) schätzen mit ihrem Modell, dass 99,98 % der Amerikaner in jedem Datensatz mit 15 demografischen Merkmalen korrekt re-identifiziert würden. (Quellen: L. Sweeney, „Simple Demographics Often Identify People Uniquely“; Rocher, Hendrickx und de Montjoye, Nature Communications; abgerufen am 22. September 2026.)
Für Dokumente gilt dasselbe: Geburtsdatum, Ort, Funktion und Arbeitgeber können zusammen eine Person verraten, auch
wenn ihr Name durch <PERSON_1> ersetzt ist.
Dokumente pseudonymisieren, bevor sie in eine KI gehen
Ein Schriftsatz zum Zusammenfassen, ein Arztbrief zum Erklären, ein Vertrag zum Abgleichen:
Mit Klarnamen im Text erhält der KI-Anbieter die personenbezogenen Daten Ihrer Mandanten oder Patienten. Werden Namen, Anschriften und Nummern vorher zu durchgängigen Platzhaltern
(dieselbe Person heißt immer <PERSON_1>) und bleibt die Zuordnungstabelle auf Ihrem Rechner,
folgt der Ablauf dem Schema von Art. 4 Nr. 5: Der Anbieter erhält Codes, die zusätzlichen Informationen bleiben
getrennt.
Wo die Tabelle liegen soll, schreibt Art. 4 Nr. 5 nicht vor; verlangt sind gesonderte Aufbewahrung und Schutz. Die Artikel-29-Datenschutzgruppe warnt: Liegt ein Geheimschlüssel „gemeinsam mit den pseudonymisierten Daten“, kann ein Angreifer die Daten nach einer Kompromittierung unter Umständen „ohne Weiteres“ mit den Originalmerkmalen verknüpfen; ebenso, wenn der Schlüssel „zwar unabhängig von den Daten, jedoch ungesichert gespeichert wird“. Unsere Empfehlung für diesen Ablauf lautet deshalb: die Tabelle lokal beziehungsweise getrennt behalten. Sie mit dem Text mitzuschicken, gäbe dem Empfänger genau die Mittel zur Re-Identifizierung, um die es im SRB-Urteil geht. (Quelle: WP 216, S. 27, abgerufen am 22. September 2026.)
Auch die Datenschutzkonferenz (DSK) nennt Pseudonymisierung im KI-Zusammenhang, und zwar in einer Orientierungshilfe (Version 1.0, Stand Juni 2025), die sich „vorrangig an Hersteller:innen und Entwickler:innen von KI-Systemen“ richtet: Das Weitertrainieren eines Modells mit personenbezogenen Ein- oder Ausgaben sei „eine zweckändernde Weiterverarbeitung“; zu prüfen sei „eine Anonymisierung dieser Daten“, und zu den nötigen Maßnahmen könne „z. B. Pseudonymisierung“ gehören. (Quelle: DSK, „Orientierungshilfe zu empfohlenen technischen und organisatorischen Maßnahmen bei der Entwicklung und beim Betrieb von KI-Systemen“ (PDF), S. 3 und 22, abgerufen am 22. September 2026.)
Von Hand ist das bei einer langen Akte fehleranfällig: Ein Name bleibt in einer Fußnote stehen, dieselbe Person bekommt im nächsten Absatz ein anderes Kürzel, eine Kontonummer steckt in einer Tabelle. Ein übersehener Name genügt, und die Kopie ist wieder zuordenbar. Schritt für Schritt: Dokumente vor ChatGPT anonymisieren; für Kanzleien KI und Mandantenvertraulichkeit und § 203 StGB und KI, für Steuerberater Mandantendaten in ChatGPT, für Praxen KI und Patientenvertraulichkeit.
Lokal pseudonymisieren mit Occlira
Occlira, eine Desktop-App für Windows und macOS (Apple Silicon), bearbeitet Dateien lokal mit zwei Werkzeugen, die im Sinne der DSGVO nicht dasselbe sind. Alle Formate, Grenzen und Netzwerkaufrufe stehen in der Funktionsübersicht.
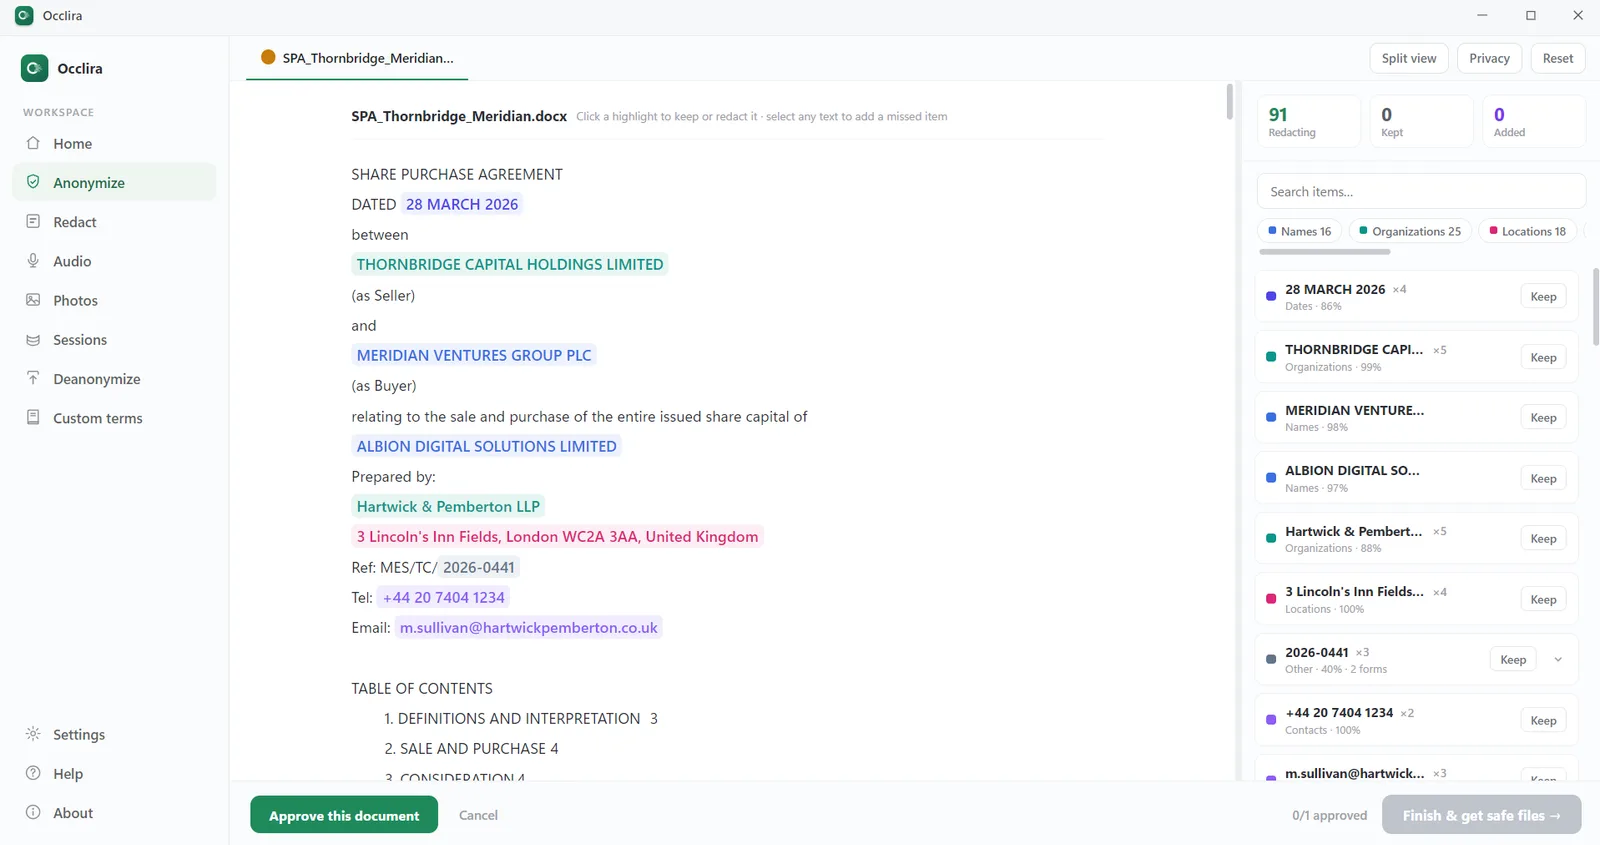
Anonymize ist eine Pseudonymisierung im Sinne von Art. 4 Nr. 5. Die Erkennung, ein lokales Modell
mit musterbasierten Regeln, schlägt die Kennungen mit einem Konfidenzwert vor; Sie prüfen die Funde und ergänzen
Übersehenes, indem Sie es im Text markieren; jeder Wert wird zu einem durchgängigen Platzhalter wie
<PERSON_1>. Word- (DOCX) und Excel-Dateien (XLSX) bleiben Word und Excel mit ihrer Formatierung; Kommentare,
Änderungsverfolgung und Dokumenteigenschaften werden bereinigt. PDFs, EML-Dateien und Bilder, auch Scans
(Texterkennung auf dem Gerät), kommen als .txt zurück; den Text kopieren Sie mit
Copy anonymized text. Die Zuordnungstabelle bleibt auf Ihrem Rechner (Dateirechte 0600) und
verfällt standardmäßig nach 7 Tagen, einstellbar. Die Antwort der KI speichern Sie als Datei;
Deanonymize setzt darin die echten Werte wieder ein und legt eine _restored-Kopie an.
Redact für PDFs und Bilder mit Text entfernt, statt zu ersetzen. In der Vorschau hat jeder Treffer
einen Rahmen; Sie können ihn abwählen, Übersehenes ergänzen oder von Hand einen Rahmen ziehen. Eingebrannt wird in
eine neue, rein bildbasierte Datei Dateiname_redacted.pdf ohne Textebene, Metadaten und Anmerkungen
des Originals, das unverändert bleibt. Das ist unumkehrbar; eine Abschlussprüfung kontrolliert, dass sich keiner
der zu entfernenden Begriffe mehr extrahieren lässt (bei Scans nur ein Hinweis über erneute Texterkennung – das
Ergebnis sollte dort zusätzlich visuell geprüft werden). Der Preis: Im Ergebnis lässt sich kein Text mehr
markieren oder durchsuchen. Redact entfernt die Daten aus dieser Kopie, macht sie aber nicht schon dadurch
„anonym“ im Sinne von Erwägungsgrund 26: Der verbleibende Kontext ist zu prüfen.
Die Erkennung läuft offline; ins Netz geht die App nur, um die Lizenz über Polar zu aktivieren, ihr Modell zu laden und nach Updates zu sehen. Mit laufender App arbeiten auch die lokalen Konnektoren: Chrome-Erweiterung für ChatGPT, Claude und Gemini (auf demselben Windows-PC), MCP-Konnektor für Claude Desktop, Add-in für Desktop-Word unter Windows und macOS. Occlira hilft, methodisch zu pseudonymisieren; die Einhaltung der DSGVO garantiert es nicht, und die Prüfung durch den Verantwortlichen ersetzt es nicht.
Häufig gestellte Fragen
Pseudonymisierung ist eine Verarbeitung personenbezogener Daten, nach der sich die Daten ohne zusätzliche Informationen, etwa eine Zuordnungstabelle oder einen Schlüssel, nicht mehr einer bestimmten Person zuordnen lassen. So definiert es Art. 4 Nr. 5 DSGVO und knüpft das an zwei Bedingungen: Die zusätzlichen Informationen werden gesondert aufbewahrt und durch technische und organisatorische Maßnahmen geschützt.
Pseudonymisierte Daten lassen sich mit gesondert aufbewahrten Informationen wieder einer Person zuordnen; sie sind grundsätzlich personenbezogen, für den Verantwortlichen gilt die DSGVO. Anonymisierte Daten erlauben keine Identifizierung mehr, auch nicht mit den Mitteln, die jemand nach allgemeinem Ermessen wahrscheinlich einsetzt; dann gilt die DSGVO nicht. Die Leitlinien 02/2026 des EDSA (in Konsultation bis 30. Oktober 2026) nennen dafür drei Kriterien: keine Isolierung von Datensätzen, keine Verknüpfung, keine Inferenz.
Grundsätzlich ja: Erwägungsgrund 26 und der EDSA behandeln sie als Informationen über eine identifizierbare Person, weil jemand sie ihr wieder zuordnen kann. Der EuGH hat 2025 präzisiert, dass sie für einen Empfänger ohne Mittel zur Re-Identifizierung je nach den Umständen keine personenbezogenen Daten sein können. Für den Verantwortlichen, der die Zuordnung kennt, bleiben sie es.
Nicht als allgemeine Regel. Die DSGVO nennt sie in Art. 25 als Beispiel einer geeigneten Maßnahme für Datenschutz durch Technikgestaltung und in Art. 32 neben der Verschlüsselung; § 22 Abs. 2 BDSG führt sie bei besonderen Kategorien personenbezogener Daten unter den möglichen Schutzmaßnahmen auf. Für Forschungs- und Statistikdaten dieser Kategorien verlangt § 27 Abs. 3 BDSG aber, die Zuordnungsmerkmale bis zur Anonymisierung gesondert zu speichern.
Sie kann es sein. ENISA zählt die Verschlüsselung zu den Pseudonymisierungstechniken, und die EDSA-Leitlinien 01/2025 nennen als geeignete Bausteine HMACs und Verschlüsselungsverfahren mit ununterscheidbaren Chiffretexten. Eine Anonymisierung ist sie nicht: Wer den Schlüssel hat, erhält die Daten im Klartext zurück. Die DSGVO führt beide Maßnahmen in Art. 32 nebeneinander auf.
Ein Hash ist eine Pseudonymisierungstechnik, ohne Schlüssel eine schwache: Bei vorhersehbaren Werten wie Namen oder Kennnummern genügt es, alle Kandidaten zu hashen und die Ergebnisse abzugleichen. Robuster ist ein Hash mit geheimem Schlüssel (HMAC), solange der Schlüssel geschützt bleibt. Einen anonymen Datensatz ergibt Pseudonymisierung für sich allein nicht.
Am 4. September 2025 (C-413/23 P) hob der Gerichtshof auf das Rechtsmittel des EDSB hin das Urteil des Gerichts auf und verwies die Sache zurück. In der Frage der pseudonymisierten Daten gab er dem Gericht aber recht: Sie sind nicht in jedem Fall und für jede Person personenbezogen. Für die Informationspflicht zählen dagegen der Zeitpunkt der Erhebung und die Sicht des Verantwortlichen.
Nicht zwingend, aber sie verringert, was der Anbieter erhält: Der Text kommt mit Codes statt Namen und Nummern an, die Zuordnungstabelle bleibt in der Kanzlei oder im Unternehmen. Anonym wird die Verarbeitung dadurch nicht, und die DSGVO gilt weiter; Datumsangaben, Orte und Funktionen im Text sollten Sie vor dem Senden trotzdem prüfen.
Art. 4 Nr. 5 DSGVO legt nicht fest, wer ihn hält. Verlangt ist, dass er gesondert von den pseudonymisierten Daten aufbewahrt und durch technische und organisatorische Maßnahmen geschützt wird; in der Regel verwahrt ihn der Verantwortliche. Gelangt der Schlüssel auch zum Empfänger, etwa als Anhang zum Text, kann dieser die Personen re-identifizieren.
Die Pseudonymisierung erlaubt die Weitergabe nicht schon für sich. Rechtsgrundlage, Zweck, Datenminimierung, Vereinbarungen mit dem Empfänger, Sicherheit und etwaige Übermittlungen außerhalb der EU sind weiter zu prüfen. Praktisch geht nur die Kopie mit den Platzhaltern hinaus; die Zuordnungstabelle sollte nicht zusammen mit der pseudonymisierten Kopie an denselben Empfänger gehen.
Weiterlesen: Was sind personenbezogene Daten? · Dokumente schwärzen · KI nutzen, ohne die DSGVO zu verletzen
Testen Sie Occlira an einem eigenen Dokument
14 Tage kostenlos unter Windows und macOS (Apple Silicon); danach Einmallizenz ab 149 € pro Platz.